
机器人家务到底做得怎么样了,距离真正解放我们的双手还有多远?拧灯泡、撕厨房纸、抽出叠放纸杯,对人类轻而易举,但在具身智能领域,如何让机器稳定完成这些看似简单的操作,一直是个难题。
过去几年,机器人基础模型逐渐从针对单项任务训练,转向利用视觉、语言和动作数据学习通用策略。视觉语言动作模型(VLA)可以根据画面和指令输出动作,世界模型则尝试预测动作执行后环境将如何变化。
但如果机器人最终要进入工位、厨房和家庭,它需要追赶的或许不只是人类“完成动作”的能力。人类已经积累了海量与现实世界交互的经验,从怎么看物体、怎样用手,到接触失败后如何调整。如何让模型、训练数据和机器人本体都围绕这些经验共同演进,正在成为具身智能的一条重要路线。
9 月 10 日,生数科技联合创始人、首席执行官(CEO)骆怡航在 2026 外滩大会发布 Motus2。该模型由生数科技研究团队与清华大学共同完成,面向高自由度灵巧操作,已在采用 WUJI Hand 2、Sharpa Wave 等灵巧手的双臂机器人上测试。
Motus2 给出的技术路线,正可从人与模型、数据和硬件关系理解。它用共享模型连接动作生成、后果预测和价值评估,从约 13 万小时人类第一视角视频中提取操作先验,再用机器人轨迹完成本体适配。在执行端,双目视觉、工作记忆和触觉传感分别补充深度、历史与接触信息。
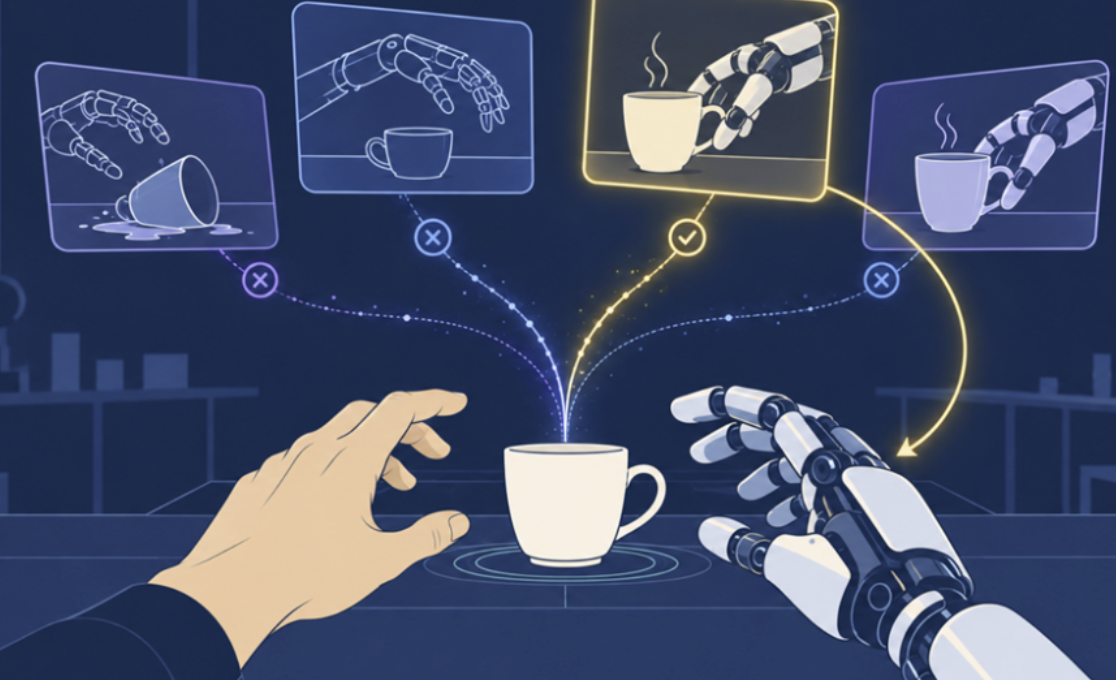
其核心变化,是让机器人在行动前“多想一步”,并把想象结果变成学习信号。前代 Motus 已联合建模视频与动作,Motus2 再加入价值模型,提出动作、预测后果并判断其是否接近目标。反馈既筛选当次动作,也用于更新策略。
给动作后果打分
如果想让机器人自主完成任务,那么首先需要回答一个问题:根据当前观测和任务指令,下一步应该执行什么动作。
工业机器人通常依赖预设轨迹、状态机或人工设计的规划器,在工位、物体位置和流程高度确定时稳定有效。一旦物体形态、摆放方式或任务指令发生变化,规则与轨迹往往需要重新设计。
近年来,模仿学习和视觉语言动作模型从示范数据中学习“观测―动作”映射,提高了任务泛化能力。但这类方法更擅长复现已有行为,通常缺少对动作后果及其任务价值的显式判断。
0
评论 (0)