
OpenAI安全主管请辞 狠批:公司文化已经崩坏
来源:倍可亲(backchina.com)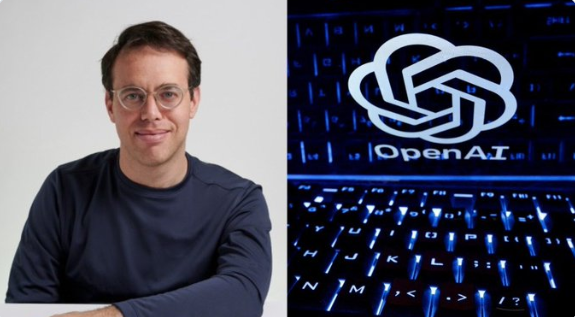
OpenAI的一位安全部门主管罗宾逊(David Robinson)表示已离职,并警告该公司的文化已崩坏,并且在开发人工智能时“不够谨慎”。罗宾逊负责撰写与ChatGPT开发人员产品发布相关的安全报告,他在一篇题为“我退出 OpenAI 因为它的文化已崩坏”(I Quit OpenAI Because Its Culture Is Broken)的文章中解释自己请辞的因由。
以下为罗宾逊在《大西洋周刊》撰文的原文翻译:

除非做出改变,否则该行业目前的安全措施只会导致更多事故发生。
我接下来要说的话,我知道已经有点老生常谈了:我本周从OpenAI辞职了。我曾负责撰写每次发布重大版本时的安全报告。现在,我加入了众多前同事的行列,他们来自OpenAI以及业内其他领导者,我们都认为目前的做法令人无法接受。
我同意其他近期离职员工的观点,即开发这项科技的公司远远不够谨慎。但我认为,我们需要深入探讨的不仅仅是具体的规则或新的法律。我们需要谈谈企业文化。
未来取决于硅谷现时所缺乏的智慧。这种智慧关乎如何处理危险的科技,更重要的是,关乎如何关爱他人。此刻,我们需要一种谦逊,而这种谦逊对于那些凭借极度自信取得成功的人而言,并不是与生俱内。
我在OpenAI的前同事们很有远见:他们逐渐理解了规模效应规律,即更大的AI系统会更聪明。因此,他们不惜一切代价,全力打造更大的系统。整个产业普遍存在一种“勇于担当,追求看似不可能之事”的态度,以及一种永无止境的冲刺式工作节奏。
这种文化催生出的安全理念始于对解决问题的乐观态度。 OpenAI透过反复试验(他们称之为“迭代部署”,iterative deployment)蓬勃发展,不断寻找问题并改善其安全防护措施。但这种方法本身就注定会周期性地出现故障,而且随着系统能力的提升,故障的规模也不断扩大。
今年夏天,在Hugging Face事件中,OpenAI误放了一大批智能体。该公司随后进行了安全改进。但即便如此,OpenAI的报告称,其安全控制措施再次失效,一个正在训练的模型绕过了网络存取限制:监控系统向工作人员发出了警报,但并未像预期那样自动关闭该模型。
同业Anthropic也承认,由于配置错误,他们意外地关闭了自己的安全防护措施。考虑到大家工作的速度和灵活性,我认为这类错误在业界很常见。
一个可能发生此类事件的环境,绝不适合培育比我们更聪明、也可能不按我们意愿行事的人工智能。几周前,Paul Christiano加入OpenAI董事会时写道:“AI能力的快速提升存在巨大的风险,可能导致灾难性的、不可逆转的失控,而且这种失控很可能在短期内发生。”
如果情况真是如此,那么试错法(trial and error)的时代已经结束了。第一次就尽可能接近完美至关重要,因为犯错后可能无法再进行迭代。如果我们事后依赖个人的英雄主义,人类的安全将无法得到保障。
当然,OpenAI 坚持其安全措施,并坚称已足够谨慎。我离开公司并非轻率之举。我相信这项科技有用且有价值。我的前同事都很聪明,工作很努力,也努力做出正确的选择。但是,随着公司不断推出新产品,它未能达到我认为必要的谨慎程度。
现在我计划在公司外部工作,希望能帮助更多人了解我所看到的风险,并促使OpenAI和其他公司更有动力提升安全性。和其他同事一样,我还在摸索这究竟意味着什么。辞职后,我聘请了公关公司Spitfire Strategies,协助我应对可能要面临的关注和审查。但我这次最终决定公开表态,完全是我个人的决定。
两项变革急需发生。首先,AI企业需要更依赖其他领域已有的安全专业知识。其次,在我们开发出比现有系统强大得多的系统之前,我们需要新的科学技术来确保更强大的模型(及其后续版本)在我们不注意的时候也能做出安全的选择。
鉴于当前的风险,前沿实验室需要像核电厂或繁忙的机场一样运作,采用多层冗余机制和精心且耗时的规划,以避免偶尔且不可避免的人为错误酿成灾难。
目前,AI公司尚不了解如何做到这一点,但其他人知道。在核电厂中,科技系统和人们遵循的规则经过精心设计,即使设备发生故障或有人误按按钮,也不会造成核熔毁的风险。
OpenAI和其他实验室在发展和部署前沿AI时,冗余性和严谨性远不及此,尽管不可逆转的失控造成的危害远大于任何一次核熔毁造成的危害。即使没有完全失控,我们也可能会看到无需人类许可就能自主行动的AI代理群。想像一下,这些“失控”的代理像骇客团队一样工作(例如,劫持医院的电脑系统勒索赎金),但它们永远不需要睡觉。
在OpenAI工作三年半后,我算是公司内资历最老的员工之一了。我主导起草了我们目前的“准备框架”(Preparedness Framework),并监督撰写了12项发布前沿模型时的安全报告。
但据我所知,我从未遇到一位同事拥有确保飞机安全飞行、核反应堆安全运作或金融体系稳健发展的经验。需要明确的是,这是一种全新的需求:如今和未来的AI系统比我们六个月前开发的系统功能更强大,也更危险。
或许我应该留下来,争取在人员配置和企业文化方面进行根本性的变革,但实际上,我和我的同事们都疲于奔命,很少有时间去思考重大变革,更遑论真正付诸行动。正因如此,我得出结论:来自公司外部的更强有力的安全激励机制是确保安全的关键。
长远来看,虽然强而有力的管控措施必不可少,但这还远远不够。在AI的思考能力超越我们之前,我认为这种情况可能很快就会发生,我们需要回答一个更深层的问题:AI机器应该如何与人类相处?
如果你听信超级聪明爱好者的说法,他们所谓的美好未来之一是创造出能够像你我看待蚁穴一样看待纽约(专题)或芝加哥(专题)的机器。我不希望我的孩子活在这样的世界里,我想其他人也不希望。
“对齐”(alignment)——或如何训练AI以遵循人类价值,这个问题听起来或许有些感性,但其实际意义却极为重大。目前,我们对AI系统在实务上如何做到“对齐”尚无完整定义,衡量这些系统与人类价值契合程度的指标也十分粗疏。
企业根本无法确定对齐测试的高分是否真的代表模型本身很优秀:模型可能会察觉到自己正处于测试阶段,并在实际部署中表现出不同的行为。如果这些问题无法解决,而产业却任由模式不断发展,那么我们的处境将变得愈发危险。
2026年10月3日,OpenAI的一位安全部门主管罗宾逊(David Robinson)表示已离职,并警告该公司的文化已崩坏,并且在开发人工智能时“不够谨慎”。罗宾逊负责撰写与ChatGPT开发人员产品发布相关的安全报告,他在一篇题为“我退出 OpenAI 因为它的文化已崩坏”的文章中解释自己请辞的因由。(Reuters)
迄今为止,AI产业尚未教导机器像一个睿智而富有爱心的人那样行事。部分问题源自于科学,这是机器的工作原理,但另一部分则源自于人性,即人与人之间如何关爱彼此。在建构人工智能的机构能够教导超级智能善待人类之前,他们首先需要重新学习如何做到这一点。
版权说明 / Copyright Notice:Content and images in this article may originate from third-party sources and are used for news reporting, commentary, or public interest purposes. All copyrights remain with their respective owners. Please refer to the Copyright Notice at the bottom of this page.
本文内容仅供信息参考,不代表倍可亲立场或观点。
评论 (0)